
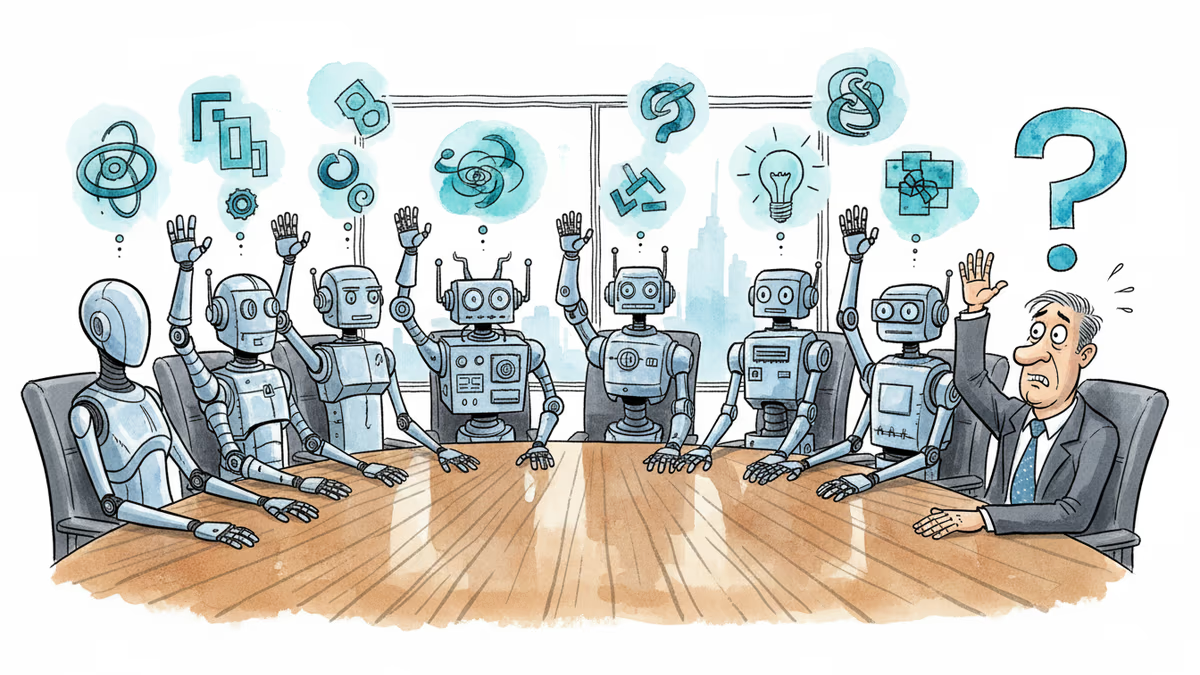
AI 답변이 틀렸을 때, 10개 모델에게 동시에 물어보면?
CollectivIQ가 ChatGPT부터 Claude까지 10개 AI 모델을 동시에 쿼리해 정확도를 높이는 방법. AI 할루시네이션 문제의 새로운 해법일까?
47%의 기업이 AI 도입을 망설이는 이유
"AI가 거짓말을 한다." 호텔 조달업체 Buyers Edge Platform의 CEO 존 데이비는 1년 전 이런 깨달음을 얻었다. 직원들이 AI 도구로 만든 프레젠테이션에서 완전히 틀린 정보를 발견한 것이다. 더 큰 문제는 회사 기밀이 AI 학습에 사용될 수 있다는 점이었다.
데이비의 고민은 많은 기업들의 현실이다. AI는 필요하지만, 할루시네이션(거짓 정보 생성)과 보안 문제 때문에 선뜻 도입하기 어렵다. 그의 해법은 단순했다. "하나가 틀리면 열 개에게 물어보자."
10개 AI가 동시에 답하는 시스템
CollectivIQ는 이런 아이디어에서 탄생했다. ChatGPT, Claude, Gemini, Grok 등 최대 10개의 AI 모델에 동일한 질문을 던지고, 답변들을 비교 분석해 더 정확한 결과를 제공한다.

작동 원리는 이렇다. 사용자가 질문을 입력하면 시스템이 여러 AI 모델의 API를 동시에 호출한다. 각 모델의 답변에서 공통점과 차이점을 찾아내 '융합된 답변'을 만든다. 모든 데이터는 암호화되고 사용 후 즉시 삭제된다고 회사는 밝혔다.
2026년 초 내부 테스트를 시작한 결과는 긍정적이었다. 직원들의 AI에 대한 불신이 줄어들고 업무 효율성이 향상됐다. 고객사들도 비슷한 고민을 하고 있다는 걸 알게 된 데이비는 이를 상용화하기로 결정했다.
기업들이 원하는 건 '완벽한 AI'가 아니다
흥미로운 점은 비즈니스 모델이다. 기존 기업용 AI 서비스는 장기 계약과 고정 요금이 일반적이다. 하지만 CollectivIQ는 사용량에 따라 과금한다. "가치만큼만 지불하라"는 것이다.
이는 기업들의 실제 니즈를 반영한다. 많은 회사들이 원하는 건 '혁신적인 AI'가 아니라 '믿을 수 있는 AI'다. 잘못된 정보 하나가 중요한 의사결정을 망칠 수 있기 때문이다.
한국 기업들도 비슷한 고민을 한다. 삼성전자나 네이버 같은 대기업은 자체 AI를 개발하지만, 중소기업들은 외부 서비스에 의존할 수밖에 없다. 하지만 보안과 정확성 문제로 도입을 주저하는 경우가 많다.
기자
관련 기사

AI기본법상 표시 위반 과태료는 시정명령을 따르지 않을 때 붙는다. PRISM이 대조한 한국 5개·대만 4개 현행 법률에서 AI 표시·공개 누락에 명령 없이 첫 위반부터 돈이 붙는 곳은 선거운동 딥페이크와 대만 플랫폼 광고 두 곳이다.

중국은 2025년 9월부터 AI 생성물 파일에 'AIGC' 메타데이터를 넣게 하고, 유통 플랫폼에 확인 의무를 뒀다. EU 실천강령 서명자는 이미지·영상·오디오에 메타데이터와 워터마크 두 겹을 자율로 약속한다. 갈리는 곳을 원문으로 본다.

HBM(고대역폭 메모리)은 D램을 수직으로 쌓아 AI 칩 옆에 붙인 메모리다. 적층·TSV 구조, HBM3·HBM4 표준 수치, SK하이닉스·삼성전자·마이크론 실적 자료에서 HBM 문구를 읽는 법을 정리했다.
EU AI법 제50조의 딥페이크·AI 생성물 표시 의무는 8월 2일부터 적용 중이다. 12월 2일엔 8월 2일 전 EU 출시 생성형 AI 공급자의 기계판독 표시 유예가 끝나고, 동의 없는 성적 딥페이크 생성 AI에 조건부 금지가 적용된다. 한국 AI기본법도 표시 의무를 둔다.
AI기본법상 표시 위반 과태료는 시정명령을 따르지 않을 때 붙는다. PRISM이 대조한 한국 5개·대만 4개 현행 법률에서 AI 표시·공개 누락에 명령 없이 첫 위반부터 돈이 붙는 곳은 선거운동 딥페이크와 대만 플랫폼 광고 두 곳이다.
중국은 2025년 9월부터 AI 생성물 파일에 'AIGC' 메타데이터를 넣게 하고, 유통 플랫폼에 확인 의무를 뒀다. EU 실천강령 서명자는 이미지·영상·오디오에 메타데이터와 워터마크 두 겹을 자율로 약속한다. 갈리는 곳을 원문으로 본다.
HBM(고대역폭 메모리)은 D램을 수직으로 쌓아 AI 칩 옆에 붙인 메모리다. 적층·TSV 구조, HBM3·HBM4 표준 수치, SK하이닉스·삼성전자·마이크론 실적 자료에서 HBM 문구를 읽는 법을 정리했다.
EU AI법 제50조의 딥페이크·AI 생성물 표시 의무는 8월 2일부터 적용 중이다. 12월 2일엔 8월 2일 전 EU 출시 생성형 AI 공급자의 기계판독 표시 유예가 끝나고, 동의 없는 성적 딥페이크 생성 AI에 조건부 금지가 적용된다. 한국 AI기본법도 표시 의무를 둔다.
의견
이 기사에 대한 생각을 나눠주세요
로그인하고 의견을 남겨보세요