
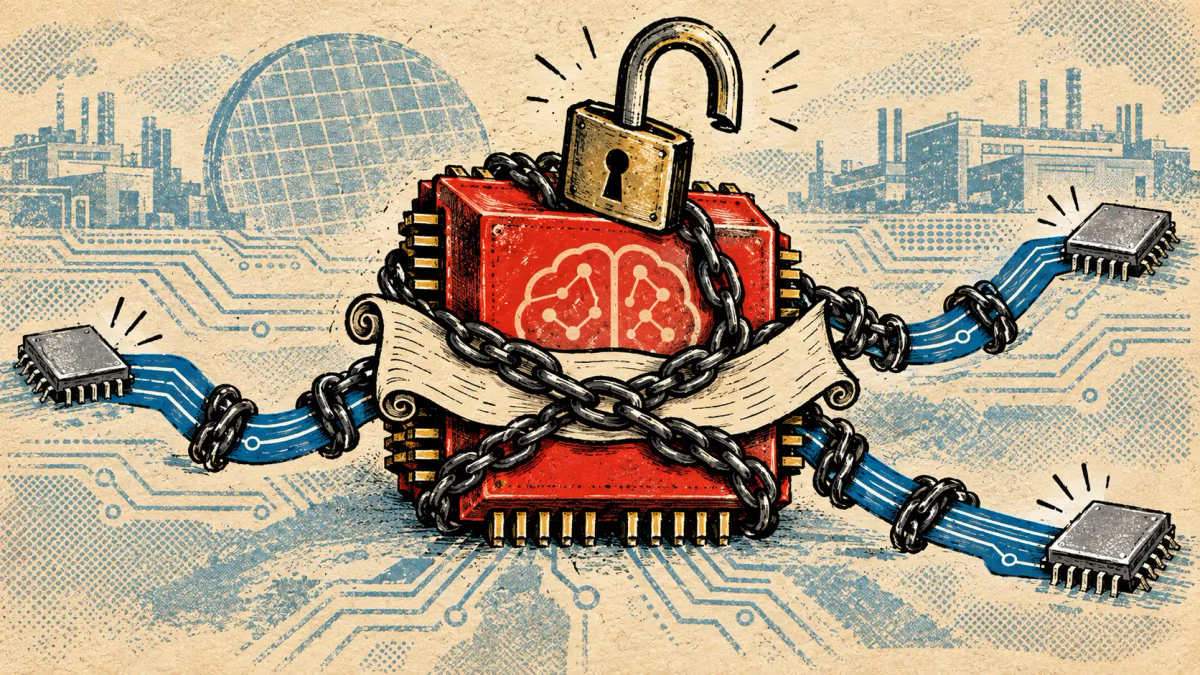
중국이 푼 오픈소스에 '화웨이 칩 전용'이 적혀 있다 — RISC-V 국산화의 역설
화웨이가 공개한 AI 스택 CANN의 라이선스에는 '어센드 이외 프로세서용 소프트웨어 개발 금지' 조항이 박혀 있다. 락인을 깨려 고른 개방이 또 하나의 락인이 되는 구조, 그리고 학습과 제조라는 두 약한 고리를 해부한다. 반도체 주권 전쟁 시리즈 3부.
오픈소스로 공개된 소프트웨어의 라이선스 본문에 이런 문장이 박혀 있다. "어센드 이외의 프로세서를 쓰는 시스템용 소프트웨어를 개발하거나 배포하는 데 이 소프트웨어를 사용해서는 안 된다."
화웨이의 AI 소프트웨어 스택 CANN, 그 한 저장소에 붙어 있는 라이선스다. 이름은 'CANN Open Software License Agreement Version 1.0'. 아파치 라이선스도 MIT 라이선스도 아니다. 화웨이가 직접 써서 붙인 문서다. 소스는 읽을 수 있다. 고칠 수도 있다. 다만 그 코드를 들고 엔비디아나 AMD 칩 쪽으로 걸어 나가는 일은 라이선스가 막는다.
이 한 문장이 3부의 질문을 요약한다. 중국은 미국 제재가 닿지 않는 재료를 골라 자기 스택을 쌓고 있다. 로열티가 없는 개방 명령어셋 RISC-V, 그리고 소스가 공개된 소프트웨어다. 그렇게 쌓아 올린 것이 또 하나의 갈아타기 힘든 스택이라면, 국산화는 무엇을 국산화한 것인가.
이 글은 PRISM 시리즈 「반도체 주권 전쟁」의 3부다. 1부는 엔비디아의 방어선을 실리콘 바깥에서 찾았다. 약 20년 쌓인 CUDA 소프트웨어 생태계다. 2부는 그 해자를 우회하려는 개방 표준 진영의 반격을 훑은 뒤 한 갈래를 남겨 뒀다. 개방 표준을 가장 절박하게 끌어안은 쪽이 국가였다는 것. 3부가 그 갈래다.
역설은 두 겹이다. 락인을 깨려고 개방을 골랐는데, 그 개방으로 쌓는 것이 또 하나의 락인이라는 것이 한 겹이다. 주권을 내걸었는데 가장 약한 고리 두 곳이 여전히 바깥에 걸려 있다는 것이 다른 한 겹이다. 학습용 연산은 엔비디아에, 제조는 파운드리 용량에 묶여 있다.
계획서에 들어간 문장, 발주서에 없는 품목
지난 8월 12일 중국 중앙국가기관 정부조달센터가 데스크톱 PC 일괄 집중구매 낙찰 결과를 냈다. 총 4,496대. 국산 CPU 플랫폼 여섯 종류가 전부 들어갔다. 하이광(海光) 2,059대, 쿤펑(鲲鹏) 1,053대, 룽신(龙芯) 494대, 자오신(兆芯) 472대, 페이텅(飞腾) 303대, 선웨이(申威) 115대다(조달센터 공고를 인용한 중국 매체 보도, 2026-08-13). 여섯 종류 어디에도 RISC-V는 없었다.
한 달 뒤인 9월 15일, 공업정보화부와 국가발전개혁위원회가 《전자정보제조업 발전 15차 5개년 계획》을 배포했다. 문서번호 工信部联规〔2026〕216호, 성문일자 9월 10일이다. 신화사가 이 계획을 인용하며 옮긴 문장에 RISC-V가 들어 있다. "제5세대 축소명령어셋(RISC-V)의 연구개발과 산업화를 추진한다"(신화사, 2026-09-16). 다만 공업정보화부가 사이트에 올린 통지에는 계획 본문이 첨부돼 있지 않고, 같은 부처가 낸 공식 해설문의 4대 주요임무에는 RISC-V가 한 번도 나오지 않는다.
두 문서 사이의 거리가 중국 RISC-V의 현재 위치다. 국가계획서에는 문장이 들어갔고, 중앙정부 발주서에는 품목이 들어가지 못했다. 다만 이 조달은 데스크톱 PC 일괄구매다. 서버와 AI 가속기 조달은 여기 포함되지 않는다.
간극은 중국 안에서도 지적된다. 신랑재경에 실린 「성해정보국」 칼럼은 올해 4월 이를 "유리천장"이라 불렀다(2026-04-07). 텐센트와 바이트댄스가 RISC-V 진영에 이름을 올렸지만 두 회사의 핵심 하드웨어 구매에서 비중은 여전히 미미하다는 것이 같은 칼럼의 지적이다.
여기서 널리 인용되는 문서 하나를 짚고 가야 한다. "중국 8개 부처가 2025년 3월 전국 RISC-V 발전 지도의견을 공동 발표했다"는 서술이 국내외에 퍼져 있다. 원 보도는 로이터다. 2025년 3월 4일 로이터는 국가인터넷정보판공실·공업정보화부·과학기술부·국가지식재산권국 등 8개 부처가 지침을 함께 준비하고 있다고 전했다. 표현은 "작성 중(being drafted)"이었고, "이달 안에 나올 수도 있으나 최종 날짜는 바뀔 수 있다"는 단서가 붙어 있었다. 1년 뒤 중국 재경 칼럼 한 편이 이를 "联合发布(공동 발표)"로 바꿔 적었다. 앞서 유리천장을 지적한 바로 그 칼럼이다. 이후 인용은 그 칼럼을 사실로 취급했다. 2026년 9월 현재 이 지침의 문서번호도, 발표일자도, 공개 본문도 중국 정부 채널에서 확인되지 않는다. 9월 15일 계획이 번호를 달고 공개된 것과 대비된다.
워싱턴 쪽 그림도 비슷하게 비어 있다. RISC-V를 수출통제 목록에 넣자는 요구는 2023년 11월 의원 18명이 상무장관에게 보낸 서한 이후 반복돼 왔다. 올해 8월에는 퇴역 대령 마이크 매캘리스터가 하원 외교위원장 브라이언 마스트에게 같은 취지로 플로리다폴리틱스에 기명 칼럼을 실었다. 법안은 아니다. 개인 기고이자 옹호 활동이다. 2026년 1월 하원 외교위원회가 대중 AI 칩 수출 법안을 가결했지만, 이 법안이 RISC-V를 명시적으로 겨냥하는지는 확인되지 않는다. 3년째 요구만 쌓였고 규칙은 나오지 않았다. 2부가 세운 전제, 곧 RISC-V가 수출통제 사정권 밖에 있다는 조건은 아직 유효하다.
서버 CPU 한 개, 로드맵 한 장
칩 층에서 RISC-V의 얼굴은 알리바바다.
3월 24일 알리바바 다모원(DAMO Academy) 행사에서 공개된 쉬안톄(玄铁) C950은 서버급 RISC-V CPU다. 회사가 밝힌 제원은 명령어 8개 동시 디코드, 16단 파이프라인, 1,000개가 넘는 비순차 실행 윈도, 최대 3.2GHz, SPECint2006 단일코어 70점 초과다(트렌드포스·EE타임스, 2026-03~04). 알리바바는 이 칩이 5나노 공정에서 검증을 마쳤다고 밝혔다. 어느 파운드리가 만드는지는 밝히지 않았다. 이 대목은 뒤에서 다시 다룬다.
주의할 구분이 하나 있다. 알리바바가 AI 프로세서라고 부르는 진무(真武) M890은 별개 제품이다. 회사는 8월 20일 실적 발표에서 M890이 알리바바 클라우드를 통해 20여 개 산업, 650곳이 넘는 외부 고객에 채택됐다고 밝혔다. 같은 발표에서 AI 클라우드·컴퓨팅 서비스 매출은 71억 달러로 전년 대비 45% 늘었고, 분기 설비투자는 100억 달러에 육박해 75% 증가했다(알리바바 2026-08-20 실적 자료). 이 실적 문서에는 RISC-V도 쉬안톄도 나오지 않는다.
9월 22일부터 24일까지 항저우에서 알리바바 윈치(云栖)대회가 열렸다. 기조연설 무대에 오른 것은 쉬안톄가 아니었다.
우융밍(吴泳铭) 알리바바그룹 CEO가 공개한 것은 AI 가속기 진무 V900이다. 회사가 밝힌 제원은 단일 칩 성능이 전작 M890의 3배, 216GB 메모리, 칩간 인터커넥트 1,200GB/s다. 양산 시점은 2027년 1분기로 제시됐다(21세기경제보도·신랑재경, 2026-09-22). 제3자 벤치마크는 아직 없다. 회사 주장이다.
서버 CPU 로드맵도 처음 공개됐다. 이톈(倚天) 720과 730을 2027년 3분기에 내놓고, 730에는 평두거(平头哥)가 전부 자체 설계한 CPU 마이크로아키텍처를 처음 적용한다는 것이다(신랑재경, 2026-09-22). 여기서 한 가지는 갈라 읽어야 한다. 보도가 말한 것은 마이크로아키텍처이고 명령어셋이 아니다. 이톈 710은 Arm 계열이고, 이번 발표에 명령어셋 표기는 없다. 자체 설계 마이크로아키텍처는 자체 명령어셋이 아니다.
그리고 없는 것이 있다. 이 기조연설을 다룬 신랑재경·21세기경제보도 등 주요 매체 보도에는 쉬안톄와 RISC-V가 나오지 않는다. 회사가 3월에 서버급 RISC-V CPU를 공개했고, 국가계획이 RISC-V를 이름으로 적은 지 일주일 된 시점이다. 연중 최대 행사에서 무게가 실린 쪽은 가속기(진무 V900)와 서버 CPU(이톈)였다.
여기서 독자가 가장 쉽게 빠지는 오독을 끊어야 한다. 중국이 RISC-V를 국가계획에 넣었다고 해서 중국 AI 가속기가 RISC-V로 돌아가는 것은 아니다. 화웨이 어센드의 연산 코어는 화웨이가 직접 설계한 다빈치(Da Vinci) 아키텍처다. 행렬 연산을 맡는 큐브 유닛, 벡터 유닛, 스칼라 유닛으로 짜여 있다(화웨이 발표자료 및 학술 문헌). 캄브리콘도 MLUarch라는 자체 명령어셋을 쓴다. 화웨이는 두 해 연속 커넥트 행사 보도자료에서 어센드의 아키텍처로 RISC-V를 언급한 적이 없다.
층을 갈라 보면 중국 스택의 재료가 한눈에 들어온다. AI 가속기의 연산 코어는 화웨이 자체 아키텍처다. 서버 호스트 CPU 층에는 화웨이 쿤펑(ARM 계열), 룽신, 페이텅이 서 있고 알리바바 쉬안톄가 그 옆에 붙는다. RISC-V가 선 자리가 여기다. 칩과 칩을 잇는 인터커넥트는 화웨이가 직접 만든 UnifiedBus 규격이고, 회사는 지난해 이 프로토콜의 사양을 개방 규격으로 공개했다. 소프트웨어 스택은 CANN이다. '제재가 닿지 않는 재료'라고 할 때 그 재료는 명령어셋과 소프트웨어라는 서로 다른 두 층을 가리킨다. 하나로 뭉뚱그리면 그림이 틀어진다.
가속기 쪽 로드맵은 화웨이가 쥐고 있다. 9월 17일 상하이 화웨이 커넥트 2026에서 왕타오(汪涛) 부회장 겸 순환회장은 어센드 960DT를 2027년 1분기에, 960PR을 3분기에 내놓겠다고 발표했다. 회사 발표에 따르면 각각 원래 로드맵보다 세 분기, 한 분기 앞당긴 일정이다. 지난해 커넥트 2025에서 쉬즈쥔(徐直军) 순환회장이 제시한 로드맵에서 어센드 960은 2027년 4분기 단일 제품이었다. 2027년 4분기에서 1분기까지는 정확히 세 분기, 3분기까지는 한 분기다. 회사가 말한 앞당김 폭은 자사 지난해 로드맵과 산술이 맞는다.
| 칩 | 지난해 로드맵(2025) | 올해 로드맵(2026) |
|---|---|---|
| 어센드 960DT | 960 단일 제품 · 2027년 4분기 | 2027년 1분기 |
| 어센드 960PR | 〃 | 2027년 3분기 |
| 어센드 970 | 2028년 4분기 | 2028년(분기 표기 없음) |
| 어센드 980 | 계획에 없음 | 2029년 |
970은 이번 발표에 분기가 적히지 않아 가속 여부를 대조할 수 없다. 앞당겨진 것으로 확인되는 제품은 960DT와 960PR 둘이다.
순서가 뒤집힌 대목이 눈에 띈다. 화웨이 명명법에서 PR과 DT는 같은 다이를 공유하는 파생 제품이고, 회사는 지난해 950DT를 "학습과 디코딩"을 겨냥한 제품으로 설명했다. 950 세대는 추론용 PR이 2026년 1분기, 학습용 DT가 4분기였다. 960 세대는 DT가 먼저다. 세 분기 앞당겨진 쪽도 DT다. 중국 스택의 약한 고리가 학습이라면 화웨이는 그 고리를 겨냥해 출시 순서를 재배열한 셈이다. 다만 이건 해석이다. 회사는 순서를 바꾼 이유를 발표문에서 설명하지 않았다.
반대 해석은 같은 행사장에서 나왔다. 중국 테크 애널리스트 루이 마는 "칩 자체는 훨씬 일찍 나오는데, 이번에 발표한 슈퍼포드는 원래 제시했던 것보다 훨씬 작다"고 지적했다(더넥스트웹, 2026-09-18). 지난해 화웨이가 제시한 아틀라스 960 슈퍼포드는 칩 1만 5,488개 규모였다. 이번에 발표된 아틀라스 960E 슈퍼포드는 NPU 최대 4,096개, FP8 8엑사플롭스, HBM 최대 1페타바이트다(회사 발표 제원). 이름이 비슷한 두 제품의 규모는 네 배 가까이 차이가 난다. 단일 칩 제원에도 격차가 남는다. 같은 매체는 960DT의 최대 288GB 메모리와 FP4 4페타플롭스가 엔비디아 B300의 FP8 절반, FP4 3분의 1 수준이라고 분석했다.
열림의 경계선
이제 소프트웨어다. 이 층이 3부의 중심이다.
CANN은 어센드 칩 위에서 AI 연산을 돌리는 소프트웨어 스택이다. CUDA가 엔비디아 GPU에 대해 하는 일을 어센드에 대해 한다. 지난해 9월 18일 커넥트 2025에서 쉬즈쥔 순환회장은 이 스택을 열겠다고 발표했다. 발표문의 문장은 정확히 이렇다. 컴파일러와 가상 명령어셋에 대해서는 "인터페이스를 개방(open interfaces)"하고, 그 밖의 소프트웨어는 완전히 오픈소스화한다. 기한은 2025년 12월 31일이었다. 개발도구 묶음인 마인드(Mind) 시리즈와 자체 기초모델 판구도 같은 기한에 묶였다.
이 문장에서 먼저 봐야 할 것은 컴파일러다. 1부의 결론에 따르면 엔비디아 해자의 실체는 층층이 쌓인 라이브러리와 컴파일러, 그 위에 얹힌 개발자층이다. 화웨이가 인터페이스만 연 부분이 정확히 그 층이다. 컴파일러 구현체 자체는 처음부터 개방 대상에 들어 있지 않았다.

1년 뒤 커넥트 2026에서 회사는 CANN이 "지속적이고 커뮤니티 주도적인 오픈소스 개발로 전환했다"고 밝혔다. 외부 개발자가 전체 CANN 개발자의 61%, 월간 활성 개발자는 5,200명이 넘는다는 수치도 함께 내놨다. 모두 화웨이 집계 기준이다. 외부에서 독립적으로 검증된 값은 아니다. 저장소 상당수가 봇 접근을 막아 두고 있어 이번 취재에서도 기여자 수를 직접 세지 못했다. 확인한 것은 2026년 9월 현재 CANN 저장소들이 공개돼 있다는 사실까지다.
CUDA와 나란히 놓고 싶은 유혹이 생기지만 단위가 다르다. 1부가 인용한 CUDA 개발자 약 600만 명은 20년 가까이 쌓인 누적치이고, 화웨이가 밝힌 5,200명은 월간 활성 개발자다. 두 숫자를 나란히 두면 오독이 된다.
그리고 라이선스가 있다.
CANN 구성요소 가운데 집합통신 라이브러리 cann-hccl의 라이선스 파일을 직접 열어 확인했다. 문서 이름은 "CANN Open Software License Agreement Version 1.0"이다. 조항 셋이 눈에 띈다. 첫째, 이용자는 "오직 어센드 프로세서와 함께 쓸 소프트웨어를 개발"할 수 있고, "어센드 이외의 프로세서를 쓰는 시스템용 소프트웨어를 개발하거나 배포"하는 데 이 소프트웨어를 쓸 수 없다. 둘째, 이 라이선스는 "로열티 없고, 양도 불가하며, 재실시권을 줄 수 없고, 취소 가능(revocable)"하다. 셋째, 이용자가 이 소프트웨어가 자신의 지식재산권을 침해한다며 법적 절차를 시작하면 화웨이가 계약을 종료할 수 있다.
이 라이선스는 OSI(오픈소스 이니셔티브) 승인 목록에서는 확인되지 않는다. 화웨이 저장소 전체가 하나의 라이선스로 묶여 있는 것도 아니다. NPU 중간표현을 다루는 AscendNPU-IR 저장소는 아파치 2.0을 쓴다. 저장소마다 조건이 다르다.
1부가 정의한 해자를 여기에 겹쳐 보면 그림이 선명해진다. 1부는 엔비디아의 방어선을 이식 비용으로 규정했다. 다른 칩으로 옮겨 타는 데 드는 비용이 새 칩이 주는 성능 이득을 웃돈다는 계산이다. CANN은 소스를 보여준다. 그런데 그 소스를 들고 다른 칩으로 옮겨 가는 행위를 라이선스 문장이 막는다. 코드가 보인다고 이식 비용이 사라지지는 않는다.
거버넌스의 위치도 다르다. 2부에서 봤듯 RISC-V를 관리하는 RISC-V 인터내셔널은 2020년 본부를 스위스로 옮겼다. 특정 국가 정부가 개방 협업을 통제하지 못하도록 중립 지대로 나간 결정이었다. CANN에는 그에 해당하는 이관이 없다. 라이선스 권한은 회사에 남아 있고, 리눅스 재단이나 아파치 재단으로 넘긴다는 발표도 없다. 개방 '표준'과 개방 '소스'는 같은 단어를 쓰지만 거버넌스 성격이 다르다.
반대편 시각도 분명히 있다. CANN은 CUDA보다 검증 가능성이 높다. CUDA는 소스 자체가 닫혀 있다. CANN은 읽을 수 있고, 버그를 찾아 고칠 수 있으며, 무엇이 어떻게 돌아가는지 확인할 수 있다. 외산 블랙박스에 의존해 온 중국 기관과 개발자에게 이건 실질적인 주권 이득이다. 회사 집계대로 외부 개발자가 61%라면 커뮤니티도 형성되는 중이다. "가짜 오픈소스"라는 규정은 과하다. 정확한 서술은 개방의 범위가 하드웨어 경계에서 끊긴다는 것이다.
기본값 이야기도 해야 한다. 화웨이는 커넥트 2026에서 어센드가 "파이토치 웹사이트에 오른 최초의 중국 연산 플랫폼"이라고 밝혔다. 파이토치 공식 사이트를 확인한 결과, 메인 페이지의 설치 선택기에서 고를 수 있는 연산 플랫폼은 CUDA 세 버전과 ROCm, CPU다. 어센드는 거기 없다. 사이트는 "하드웨어에 맞는 플랫폼을 찾지 못했다면" 별도의 '추가 플랫폼' 페이지를 보라고 안내한다. 그 페이지는 "파트너와 커뮤니티 구성원이 제공하는" 플랫폼 목록이고, 지원 채널을 따로 표시하는 열을 둔다. 회사 주장이 거짓이라고 볼 근거는 없다. 어센드용 파이토치 백엔드 torch_npu는 실재하고 저장소도 활발하다. 다만 설치 화면의 기본값 자리는 여전히 CUDA가 지키고 있다. 1부가 말한 해자가 어디에 있는지 보여주는 장면이다.
회사는 어센드가 파이토치, 트리톤, vLLM, veRL을 포함해 90개가 넘는 서드파티 오픈소스 프로젝트를 지원한다고 밝혔다. 목록은 공개되지 않았고 확인할 방법도 없다. 다만 그 안에 트리톤이 들어 있다는 점은 짚어둘 만하다. 2부는 트리톤을 벤더 중립의 가장 근본적인 무기로 소개했다. 그 중립 계층을 중국 스택이 흡수하고 있다.
이 절의 질문에 답하면 이렇다. CANN의 개방은 검증 가능성을 늘렸다. 이동 가능성은 늘리지 않았다. 소스코드의 가시성이 달라졌고, 다른 칩으로 갈아탈 자유는 그대로 묶여 있다. 락인 장치는 CUDA와 같은 자리에 있다. 달라진 것은 그 장치를 쥔 회사의 국적이다.
추론은 옮겼고, 학습은 남았다
모델 층으로 올라가면 경계선이 더 또렷해진다.
올해 4월, 파라미터 1조 6,000억 개 규모의 전문가혼합(MoE) 모델 딥시크 V4가 어센드 950PR에서 추론 검증을 마쳤다는 보도가 나왔다(톰스하드웨어·트렌드포스, 2026-04). 다섯 달 뒤 블룸버그는 9월 4일 딥시크가 내몽골 신규 데이터센터에 어센드 950DT를 16만 개 이상 들이는 계획을 세웠다고 단독 보도했다. 같은 보도는 이 칩들이 추론 전용이고 학습에는 엔비디아 GPU를 계속 쓴다고 명시했다. 국내외에 2차 인용이 많지만 원 보도는 블룸버그 하나다. 그리고 950DT는 화웨이 로드맵상 올 4분기 제품이다. 회사는 이 칩의 양산이나 출하를 발표한 적이 없고, 커넥트 2026 보도자료에는 950 시리즈 언급 자체가 없다. 아직 나오지 않은 칩에 대한 도입 계획이라는 뜻이다.
사후학습 쪽에서는 7월에 논문이 하나 나왔다. arXiv 2607.20145, 제목은 「SLAI T-Rex: 어센드 슈퍼포드에서 딥시크-V4 계열의 전체 파라미터 사후학습」이다. 저자는 65명이고, 기관 저자는 선전 허타오연구원(Shenzhen Loop Area Institute)의 AI 학습 플랫폼 팀이다. 논문 저자 표기에 화웨이는 나오지 않는다. 화웨이 참여는 외신 보도로만 확인된다. 사용한 시스템은 어센드 910C를 쓰는 클라우드매트릭스384 슈퍼포드이고, 칩 총수는 논문에 적혀 있지 않다. 흔히 함께 인용되는 "최소 1,000개"의 출처는 논문이 아니다. 선전시 정부 자료에서 나온 수치다.
논문이 보고한 성과는 하드웨어 이용률(MFU)을 11.67%에서 34.22%로 끌어올렸다는 것이다. 연구팀은 이를 "오픈소스 베이스라인 레시피 대비 2.93배"라고 적었다. 비교 대상을 정확히 읽어야 한다. 2.93배의 기준은 연구팀 자신의 미최적화 설정이다. 엔비디아와의 비교는 여기 없다. 11.67에 2.93을 곱하면 34.19가 나온다. 2부에서 AMD가 ROCm 7.0의 성능 개선을 "최대 4배"라고 밝혔을 때 그 기준이 이전 버전 ROCm 6이었던 것과 같은 구조다. 이 시리즈에서 두 번째로 마주치는 함정이다.
무엇보다 이 논문은 사후학습만 다룬다. 이미 학습을 마친 모델을 추가로 다듬는 단계다. 논문은 딥시크-V4를 애초에 어떤 하드웨어가 학습시켰는지 규명하지 않는다고 스스로 밝힌다. 칭화대 류즈위안 교수는 딥시크가 V4 학습 과정의 일부만 중국산 칩에 맞춰 적응시킨 것으로 보이며, 모델은 여전히 주로 엔비디아 하드웨어에서 학습됐을 수 있다고 공개적으로 지적했다(MIT 테크놀로지 리뷰 인용). 톰스하드웨어는 최초 주장에 벤치마크가 없었다는 점을 문제 삼았다.
AI 모델을 만드는 과정은 세 칸으로 갈린다. 파라미터를 바닥부터 학습시키는 사전학습, 이미 학습된 모델을 미세조정하고 정렬하는 사후학습, 완성된 모델을 돌려 답을 만드는 추론이다. 연산량은 앞쪽이 압도적으로 크다. 어센드가 실적을 낸 구간은 뒤쪽 둘이다. 사전학습을 어센드로 해냈다는 근거는 아직 공개된 적이 없다.
개수와 연산량
화웨이는 커넥트 2026에서 아틀라스 900 A3 슈퍼포드를 1,000기 넘게 배치했다고 밝혔다. 고객도, 지역도, 시점도 함께 공개하지 않았다. 제3자 확인은 없다. 화웨이가 실제로 얼마나 만드느냐는 질문에는 회사 발표 바깥에 추정이 하나 있다.
독립 AI 연구기관 Epoch AI가 9월 4일 「화웨이는 2030년까지 엔비디아를 따라잡을까」라는 분석을 냈다. Epoch AI 추정으로는 2026년 화웨이가 어센드 계열 칩 150만 개를, 엔비디아가 590만 개를 생산한다. 개수로 보면 화웨이가 엔비디아의 약 4분의 1이다. 그런데 같은 추정에서 H100 환산 연산량은 화웨이 88만, 엔비디아 2,300만이다. 비중으로는 4% 아래다.
같은 해, 같은 두 회사를 두고 단위를 바꾸면 결론이 뒤집힌다. 개수를 세면 추격처럼 보이고, 연산량을 세면 격차가 그대로 남는다. 이건 추정치이고 사실로 단정할 수 없다. 다만 방향은 다른 분석과 어긋나지 않는다. 미 외교협회(CFR) 분석도 2026년 화웨이 비중을 4% 수준으로 본다.
Epoch AI가 꼽은 제약 요인은 셋이다. HBM 메모리가 구속 조건이고, SMIC가 5~7나노에 묶여 대만의 선단 공정에 접근하지 못하며, 칩당 성능이 엔비디아에 3~4년 뒤처진다는 것이다. 보고서의 결론 문장은 이렇다. "화웨이의 공개 로드맵은 야심적이지만 엔비디아 자신의 칩당 성능 진전을 감안하면 충분하지 않다." 그리고 "수출통제가 화웨이의 가장 중요한 확장 레버를 제약해 엔비디아를 따라잡기 어렵게 만든다."
이 문장은 영어권에서 진행 중인 논쟁에 직접 답한다. 한쪽에는 통제가 중국 국산화를 오히려 앞당겼다는 젠슨 황의 역효과론이 있고, 다른 쪽에는 통제를 더 조여야 한다는 의회의 입장이 있다. 이 시리즈가 4부에서 다룬 전장이다. Epoch AI의 추정은 통제가 효과를 내고 있다는 쪽에 무게를 싣는다.
한 가지 더 밝혀둘 것이 있다. 이 기사에 나오는 화웨이 성능 수치는 전부 회사가 스스로 밝힌 값이다. 최신 어센드 950·960 계열은 MLPerf 같은 공개 벤치마크에 제출된 기록이 확인되지 않는다. 구형 910은 2020년경 MLPerf 학습 부문에 제출한 이력이 있고 화웨이 스토리지 제품은 지금도 제출한다. 최신 AI 가속기 쪽만 공백이다. 지난해 11월과 올해 6월 MLPerf 학습 제출사 명단에도 화웨이는 없었다.
가동률 93.7%
두 번째 약한 고리는 제조다.
SMIC는 8월 13일 2분기 실적을 공시했다. 공시를 인용한 보도에 따르면 매출은 30억 600만 달러로 전분기 대비 20.0%, 전년 동기 대비 36.1% 늘었다. 주목할 것은 세 숫자다. 가동률 93.7%, 월 생산능력 8인치 환산 109만 6,500장, 웨이퍼 출하 286만 9,000장.
앞 분기와 비교하면 그림이 나온다. 가동률은 1분기 93.1%에서 올랐고, 회사는 3분기에도 90% 중반을 유지하겠다고 가이던스로 밝혔다. 생산능력은 1분기 107만 8,300장에서 1.7% 늘었다. 그런데 출하는 14.4% 늘었다. 웨이퍼 평균판가는 전분기 대비 5.7% 올랐고, 매출총이익률은 20.1%에서 25.3%로 뛰었다. 증설이 수요를 따라가지 못할 때 나오는 조합이다. 상반기 설비투자를 34억 달러가량 집행하고도 그랬다.
용도별로 보면 선단 공정과의 거리가 드러난다. 2분기 매출에서 소비자전자가 44.2%, 스마트폰 16.9%, 산업·자동차 16.5%, 컴퓨터·태블릿 15.6%를 차지했다. 지역별로는 90.2%가 중국 안에서 나왔다. 이번 실적 발표에서 SMIC는 5나노는 물론 선단 공정을 한 번도 언급하지 않았다. 영문 요약과 중문 요약 양쪽에서 같은 부재가 확인된다. 회사가 AI 관련 수요로 꼽은 품목은 전력관리 칩과 인터페이스 칩이었다.
알리바바 C950 이야기가 여기서 매듭을 짓는다. 알리바바는 이 칩이 5나노 공정에서 검증됐다고 밝혔을 뿐 파운드리를 공개하지 않았다. 닛케이 아시아는 3월 26일 복수의 소식통을 인용해 "양산 단계로 넘어가면" TSMC가 만들 것이라고 전했다. 미래형 문장이고, 그 시점에 C950은 양산 전이었다. 알리바바도 TSMC도 이를 확인하거나 부인한 적이 없다. 분명한 것은 5나노가 중국 본토에서 만들 수 없는 공정이라는 점이다. TSMC 난징 팹은 16나노 이상 성숙 공정으로 제한돼 있고 EUV 장비는 중국 안으로 들어가지 못한다. 미 상무부 산업안보국은 지난해 1월 중국 설계사가 해외에서 첨단 노드 칩을 받는 것을 제한하는 규칙을 냈다. C950이 그 성능 기준에 걸리는지는 별도 판단이 필요하다. 여기서 말할 수 있는 것은 대만 팹 경로가 자명하지 않다는 데까지다.
메모리도 같은 자리에 있다. Epoch AI가 화웨이의 첫 번째 구속 조건으로 꼽은 것이 HBM이다. 화웨이는 지난해 커넥트 2025에서 자체 HBM인 HiBL 1.0과 HiZQ 2.0을 공개했는데, 올해 커넥트 2026 보도자료에는 이 이름들이 나오지 않는다. 진척이 업데이트되지 않았다는 사실 자체가 정보다. 반도체 분석기관 세미애널리시스도 지난해 9월 분석에서 중국의 병목으로 웨이퍼 생산능력 대신 HBM을 꼽았다. 1년 전 시점의 진단이라는 점은 감안해야 한다.
같은 발표, 네 개의 독법
이 스택을 보는 눈은 언어권마다 다르다.
대만 안에서도 갈린다. 경제일보는 어센드 960의 조기 등장을 "엔비디아에 도전장(叫陣輝達)" 틀로 보도하며 "진척이 예상을 웃돈다(進度超預期)"고 썼다. 같은 시기 뉴토크는 "칩을 쌓아서 연산력을 겨룬다(靠「堆晶片」拚算力)"를 제목에 걸었다. 물량으로 메운다는 함의이고, 루이 마와 더넥스트웹의 지적과 같은 방향이다.
본토 매체는 같은 사실을 정반대 가치로 읽는다. 신랑은 "단일 카드 성능이 두 배가 된 것은 기초일 뿐이고, 화웨이 어센드 960의 돌파는 클러스터 연결에 있다"를 제목으로 뽑았다. 서방 분석이 '칩당 성능 격차'라고 부르는 지점을 본토는 '클러스터가 핵심'이라고 읽는다. 사실은 같고 값이 다르다.
표준을 파는 쪽의 좌표는 또 다르다. 대만 안데스(晶心科)는 세계 RISC-V IP 시장의 30% 이상을 쥔 회사다. 이 회사의 2025년 최대 매출처는 미국(37%)이었고 대만(36%)이 뒤를 이었다. 회사는 중국을 "가격 경쟁이 치열한 시장"으로 규정하고 AI·산업·자동차 쪽으로 무게를 옮겼다고 밝혔다(실적설명회, 2026-03-18). 2부에서 다룬 메타의 추론 칩 MTIA가 이 회사의 코어를 채택해 양산에 들어갔다. 같은 개방 표준을 놓고 베이징은 주권을 말하고 타이베이는 단가를 말한다.
일본은 장비 관점에서 본다. 도쿄일렉트론의 중국 매출 비중은 2026년 3월기 연간 34.1%, 4분기 26.8%로 집계됐다(일본 매체가 전한 결산설명회 자료 기준). 비중이 내려간 이유로는 선단 공정용 투자의 성장률이 더 높았던 점이 꼽혔다. 일본 장비는 중국 국산화의 수혜자이면서 동시에 중국 의존을 줄여야 하는 이중 위치에 있다.
한국에는 더 직접적인 층이 있다. 화웨이코리아 발리안 왕 CEO는 지난해 12월 서울 기자간담회에서 2026년 한국에 AI 컴퓨팅 카드와 AI 데이터센터 솔루션을 내놓고 어센드 950을 도입하겠다고 밝혔다. 칩을 낱개로 파는 대신 클러스터 구성으로 공급하겠다는 설명이었다. 국내 매체는 이를 대체로 "희망"이라는 단어로 받았다. 트렌드포스는 올해 7월 한국 매체를 인용해 화웨이코리아가 4분기에 어센드 950 계열과 아틀라스 950 슈퍼포드를 한국에 출시하려 하며 국내 파트너사를 통한 유통이 추진된다고 보도했다. 같은 보도는 중국 기술에 대한 현지 민감도와 발열에 따른 전력소모를 걸림돌로 꼽았다.
설계 쪽 좌표도 있다. ETRI의 RISC-V 설계 플랫폼 RVX는 로열티 없는 표준이 국내 팹리스의 진입 문턱을 낮추는 사례다. 다만 상업성은 아직 ARM에 못 미친다는 평가가 업계에서 우세하다.
관문은 하나 더 있다. Epoch AI가 화웨이의 구속 조건으로 지목한 HBM 시장의 중심에 삼성전자와 SK하이닉스가 있다. 한국 메모리업계는 이 구도에서 중국 AI 확장의 결정적 관문이자, 대중 규제의 적용을 받는 쪽이며, 화웨이 자체 HBM과 CXMT 증설이 겨냥하는 대체 대상이기도 하다. 세 위치가 동시에 성립한다.
남는 좌표
3부가 남기는 사실은 두 가지다. 중국은 제재가 닿지 않는 재료로 CPU와 가속기, 소프트웨어와 모델까지 자기 스택을 세웠다. 그리고 그 스택의 두 층이 아직 바깥에 걸려 있다. 사전학습을 감당할 연산과, 선단 공정을 돌릴 제조 용량이다.
중국의 계획서에는 RISC-V가 문장으로 들어갔다. 중앙정부 데스크톱 발주서에는 아직 들어가지 못했다. 두 문서 사이의 거리가 지금 국산화의 좌표다. 10월 18일 선전에서 RISC-V 서밋 차이나가 열린다. 기조연설자 명단에는 RISC-V를 설계한 데이비드 패터슨과 RISC-V 인터내셔널 CEO 안드레아 갈로가 올라 있다. 스위스로 본부를 옮겨 중립을 확보한 조직이, 자국 5개년 계획에 그 표준을 적어 넣은 나라의 도시에서 무대에 선다.
시리즈의 네 번째 편은 이미 나와 있다. 1부의 CUDA 해자, 2부의 개방 표준 반격, 그리고 3부의 중국 스택 다음에 읽을 자리는 4부 수출통제 편이다. 규제가 점유율을 직접 흔드는 국면을 다룬다.
본 콘텐츠는 AI가 원문 기사를 기반으로 요약 및 분석한 것입니다. 정확성을 위해 노력하지만 오류가 있을 수 있으며, 원문 확인을 권장합니다.
관련 기사
엔비디아는 2024년 자사 칩에 개방 명령어셋 RISC-V를 약 10억 개 심었고, 2025년엔 CUDA를 RISC-V 위에서 돌리겠다고 발표했다. 로열티 없는 개방 표준과 오픈 소프트웨어 스택이 CUDA 락인을 우회하려는 반격을 해부한다. 반도체 주권 전쟁 시리즈 2부.
미국의 AI 칩 수출통제는 2026년 상반기 완화(1월)·우회봉쇄(5월)·계류 법안의 세 층으로 갈렸다. 엔비디아는 중국을 실적에서 지우고도 분기 816억 달러 최고 매출을 냈다. 방패이자 족쇄가 된 수출정책을 해부한다.
AMD MI325X는 메모리·대역폭에서 앞서지만 엔비디아 점유율은 여전히 86~92%. 진짜 해자는 20년 쌓인 CUDA 소프트웨어 생태계다. 반도체 주권 전쟁 시리즈 1부, 엔비디아가 흔들리지 않는 이유를 분석한다.
중국이 AI 연구자와 스타트업 창업자의 해외 출국을 제한하기 시작했다. 스탠퍼드 AI 인덱스에 따르면 미중 AI 성능 격차는 2023년 31%에서 2026년 2.7%로 좁혀졌다. 베이징의 선택이 글로벌 AI 경쟁 구도를 어떻게 바꾸는가.
엔비디아는 2024년 자사 칩에 개방 명령어셋 RISC-V를 약 10억 개 심었고, 2025년엔 CUDA를 RISC-V 위에서 돌리겠다고 발표했다. 로열티 없는 개방 표준과 오픈 소프트웨어 스택이 CUDA 락인을 우회하려는 반격을 해부한다. 반도체 주권 전쟁 시리즈 2부.
미국의 AI 칩 수출통제는 2026년 상반기 완화(1월)·우회봉쇄(5월)·계류 법안의 세 층으로 갈렸다. 엔비디아는 중국을 실적에서 지우고도 분기 816억 달러 최고 매출을 냈다. 방패이자 족쇄가 된 수출정책을 해부한다.
AMD MI325X는 메모리·대역폭에서 앞서지만 엔비디아 점유율은 여전히 86~92%. 진짜 해자는 20년 쌓인 CUDA 소프트웨어 생태계다. 반도체 주권 전쟁 시리즈 1부, 엔비디아가 흔들리지 않는 이유를 분석한다.
중국이 AI 연구자와 스타트업 창업자의 해외 출국을 제한하기 시작했다. 스탠퍼드 AI 인덱스에 따르면 미중 AI 성능 격차는 2023년 31%에서 2026년 2.7%로 좁혀졌다. 베이징의 선택이 글로벌 AI 경쟁 구도를 어떻게 바꾸는가.
의견
이 기사에 대한 생각을 나눠주세요
로그인하고 의견을 남겨보세요