
AI를 외계생물처럼 연구하는 새로운 생물학자들
거대 언어모델의 작동 원리를 이해하기 위해 생물학적 접근법을 사용하는 연구자들. 수십억 명이 사용하는 기술을 아무도 완전히 이해하지 못한다는 문제의 해법을 찾고 있다.
수십억 명이 매일 사용하는 기술을, 그 기술을 만든 사람조차 완전히 이해하지 못한다면?
ChatGPT나 Claude 같은 거대 언어모델(LLM)이 바로 그런 존재다. 이들은 너무 크고 복잡해서 창조자마저 정확히 어떻게 작동하는지, 진짜 한계가 무엇인지 모른다. 문제는 이런 '미지의 기술'을 전 세계 수억 명이 일상적으로 쓰고 있다는 점이다.
외계생물을 해부하듯 AI를 연구하다
이 무지의 장벽을 뚫기 위해, 연구자들이 새로운 접근법을 시도하고 있다. 거대 언어모델을 마치 도시 크기의 외계생물처럼 취급해 생물학이나 신경과학 기법으로 연구하는 것이다.
이들이 발견한 건 충격적이다. LLM은 생각했던 것보다 훨씬 기묘한 존재였다. 기계학습 해석 기법(mechanistic interpretability)을 통해 AI 모델의 '뇌'를 들여다보니, 예상과 전혀 다른 패턴들이 나타났다.
MIT 테크놀로지 리뷰는 이 연구 분야를 2026년 10대 혁신 기술 중 하나로 선정했다. 그만큼 중요하다는 뜻이다.

한국 AI 산업에 던지는 메시지
국내에서도 네이버의 하이퍼클로바X, 카카오브레인의 언어모델 등이 활발히 개발되고 있다. 하지만 이들 역시 '블랙박스' 문제에서 자유롭지 못하다.
특히 AI가 의료진단이나 금융서비스 같은 중요한 영역에 도입되면서, '설명 가능한 AI'에 대한 요구가 높아지고 있다. 환자나 고객에게 "AI가 그렇게 판단했습니다"라고만 할 수는 없기 때문이다.
투명성과 효율성 사이의 딜레마
AI를 완전히 이해하려는 노력이 과연 옳을까? 일부 전문가들은 의문을 제기한다. 인간의 뇌도 완전히 이해하지 못하면서 잘 사용하고 있지 않냐는 것이다.
하지만 다른 관점도 있다. AI는 인간이 만든 도구이고, 특히 사회 전반에 미치는 영향이 크다면 최소한의 투명성은 확보해야 한다는 주장이다.
기자
관련 기사

AI기본법상 표시 위반 과태료는 시정명령을 따르지 않을 때 붙는다. PRISM이 대조한 한국 5개·대만 4개 현행 법률에서 AI 표시·공개 누락에 명령 없이 첫 위반부터 돈이 붙는 곳은 선거운동 딥페이크와 대만 플랫폼 광고 두 곳이다.

중국은 2025년 9월부터 AI 생성물 파일에 'AIGC' 메타데이터를 넣게 하고, 유통 플랫폼에 확인 의무를 뒀다. EU 실천강령 서명자는 이미지·영상·오디오에 메타데이터와 워터마크 두 겹을 자율로 약속한다. 갈리는 곳을 원문으로 본다.

HBM(고대역폭 메모리)은 D램을 수직으로 쌓아 AI 칩 옆에 붙인 메모리다. 적층·TSV 구조, HBM3·HBM4 표준 수치, SK하이닉스·삼성전자·마이크론 실적 자료에서 HBM 문구를 읽는 법을 정리했다.
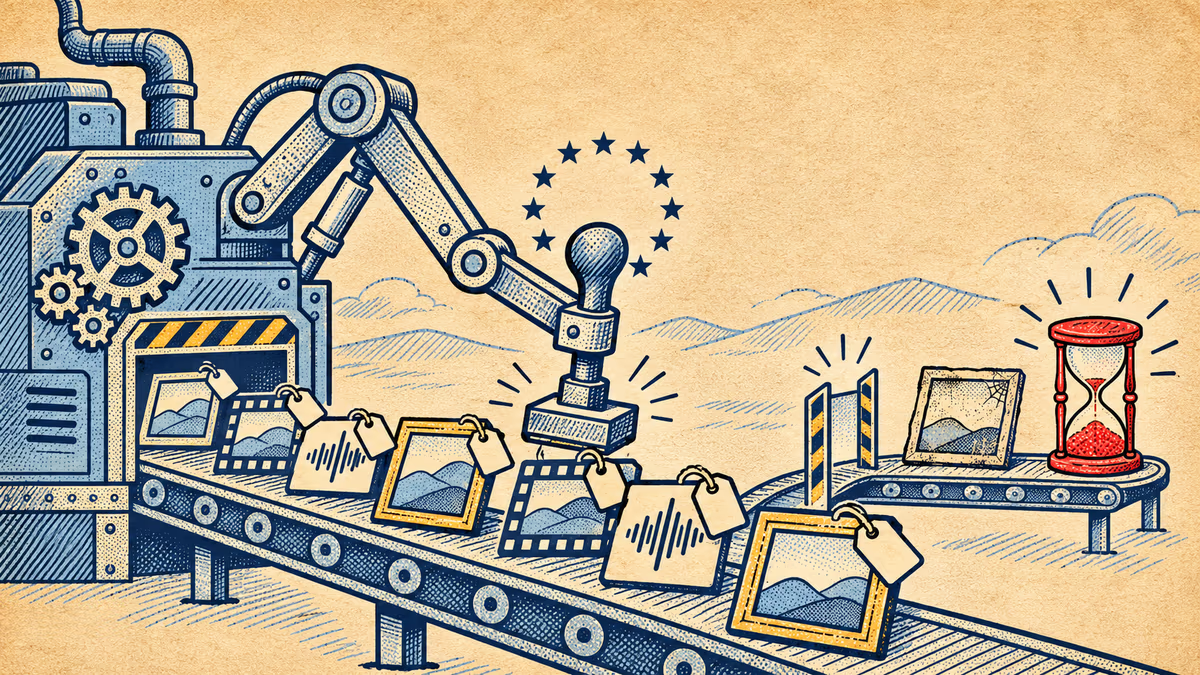
EU AI법 제50조의 딥페이크·AI 생성물 표시 의무는 8월 2일부터 적용 중이다. 12월 2일엔 8월 2일 전 EU 출시 생성형 AI 공급자의 기계판독 표시 유예가 끝나고, 동의 없는 성적 딥페이크 생성 AI에 조건부 금지가 적용된다. 한국 AI기본법도 표시 의무를 둔다.
AI기본법상 표시 위반 과태료는 시정명령을 따르지 않을 때 붙는다. PRISM이 대조한 한국 5개·대만 4개 현행 법률에서 AI 표시·공개 누락에 명령 없이 첫 위반부터 돈이 붙는 곳은 선거운동 딥페이크와 대만 플랫폼 광고 두 곳이다.
중국은 2025년 9월부터 AI 생성물 파일에 'AIGC' 메타데이터를 넣게 하고, 유통 플랫폼에 확인 의무를 뒀다. EU 실천강령 서명자는 이미지·영상·오디오에 메타데이터와 워터마크 두 겹을 자율로 약속한다. 갈리는 곳을 원문으로 본다.
HBM(고대역폭 메모리)은 D램을 수직으로 쌓아 AI 칩 옆에 붙인 메모리다. 적층·TSV 구조, HBM3·HBM4 표준 수치, SK하이닉스·삼성전자·마이크론 실적 자료에서 HBM 문구를 읽는 법을 정리했다.
EU AI법 제50조의 딥페이크·AI 생성물 표시 의무는 8월 2일부터 적용 중이다. 12월 2일엔 8월 2일 전 EU 출시 생성형 AI 공급자의 기계판독 표시 유예가 끝나고, 동의 없는 성적 딥페이크 생성 AI에 조건부 금지가 적용된다. 한국 AI기본법도 표시 의무를 둔다.
의견
이 기사에 대한 생각을 나눠주세요
로그인하고 의견을 남겨보세요