
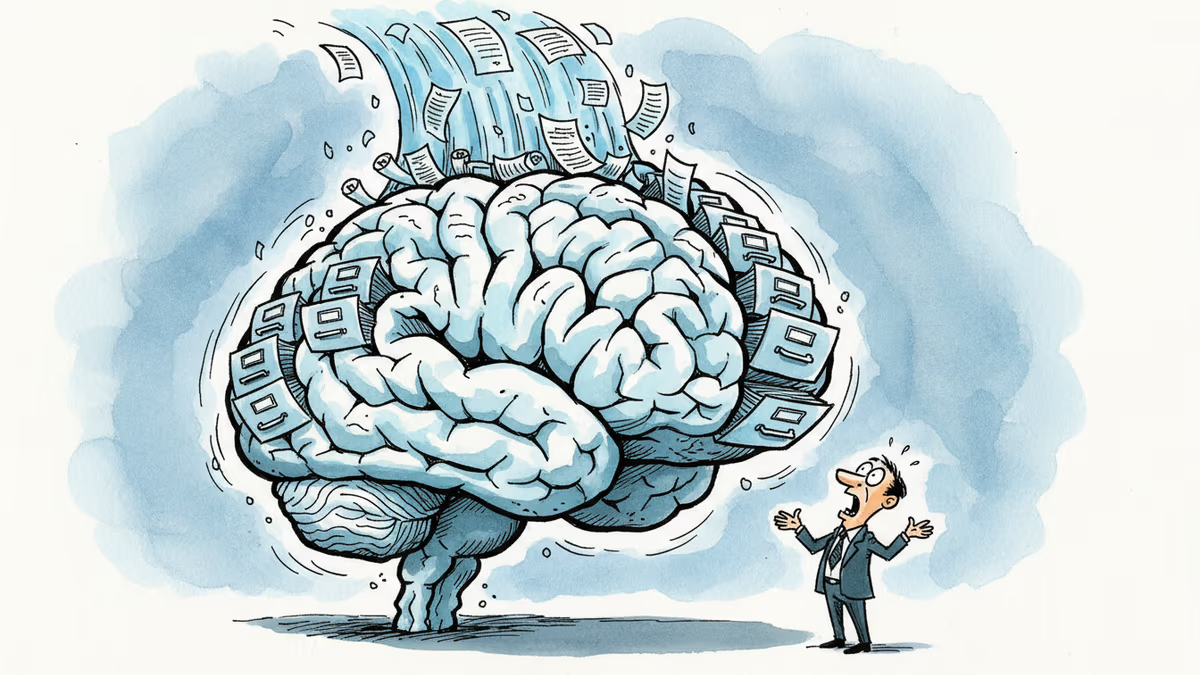
AI가 '기억력 게임'으로 변하고 있다
Anthropic의 Sonnet 4.6이 100만 토큰 컨텍스트 윈도우로 출시. AI 모델들이 성능보다 기억력 경쟁에 돌입한 배경과 의미를 분석한다.
100만 토큰이 새로운 전장이 되었다
Anthropic이 Sonnet 4.6을 출시하며 컨텍스트 윈도우를 100만 토큰으로 두 배 확장했다. '전체 코드베이스나 수십 편의 연구 논문을 한 번에 처리할 수 있다'는 설명이다. 하지만 정말 중요한 건 이 숫자가 아니다.
AI 업계가 지금 벌이고 있는 게임의 본질이 바뀌고 있다는 신호다.
성능에서 기억력으로 이동하는 경쟁 축
4개월 주기로 업데이트를 이어가는 Anthropic의 전략은 명확하다. 이번에도 ARC-AGI-2에서 60.4%를 기록하며 대부분의 경쟁 모델을 앞섰다. 하지만 여전히 OpenAI의 GPT 5.2나 Google의 Gemini 3 Deep Think보다는 뒤처진다.
흥미로운 점은 이제 AI 회사들이 '더 똑똑한 AI'보다 '더 많이 기억하는 AI'를 강조한다는 것이다. 컨텍스트 윈도우 확장은 단순히 더 긴 텍스트를 처리하는 게 아니다. AI가 작업하는 방식 자체를 바꾼다.

개발자들에게는 희소식이다. 이제 코드 전체를 AI에게 보여주고 '이 버그 어디 있어?'라고 물어볼 수 있다. 변호사들은 계약서 더미를 통째로 넣고 분석을 요청할 수 있다.
한국 기업들이 놓치고 있는 것
국내 AI 기업들은 여전히 '한국어 특화'나 '로컬 데이터'에만 집중한다. 네이버의 HyperCLOVA X나 카카오브레인의 KoGPT가 그 예다. 하지만 컨텍스트 윈도우 경쟁에서는 현저히 뒤처져 있다.
삼성전자나 LG전자 같은 대기업들이 AI를 제품에 통합할 때, 이런 '기억력 차이'는 사용자 경험의 결정적 격차로 이어진다. 스마트폰에서 하루 종일 쌓인 대화 맥락을 기억하는 AI와 매번 새로 시작하는 AI의 차이를 생각해보라.
개인정보와 효율성의 딜레마
하지만 더 큰 기억력은 더 큰 위험도 의미한다. 100만 토큰이면 개인의 이메일 수개월치, 업무 문서 전체, 심지어 의료 기록까지 한 번에 처리할 수 있다.
유럽의 GDPR이나 한국의 개인정보보호법 관점에서 보면, 이런 대용량 데이터 처리는 새로운 규제 이슈를 낳을 수밖에 없다. 기업들은 효율성과 개인정보 보호 사이에서 더 복잡한 선택을 해야 한다.
기자
관련 기사

AI기본법상 표시 위반 과태료는 시정명령을 따르지 않을 때 붙는다. PRISM이 대조한 한국 5개·대만 4개 현행 법률에서 AI 표시·공개 누락에 명령 없이 첫 위반부터 돈이 붙는 곳은 선거운동 딥페이크와 대만 플랫폼 광고 두 곳이다.

중국은 2025년 9월부터 AI 생성물 파일에 'AIGC' 메타데이터를 넣게 하고, 유통 플랫폼에 확인 의무를 뒀다. EU 실천강령 서명자는 이미지·영상·오디오에 메타데이터와 워터마크 두 겹을 자율로 약속한다. 갈리는 곳을 원문으로 본다.

HBM(고대역폭 메모리)은 D램을 수직으로 쌓아 AI 칩 옆에 붙인 메모리다. 적층·TSV 구조, HBM3·HBM4 표준 수치, SK하이닉스·삼성전자·마이크론 실적 자료에서 HBM 문구를 읽는 법을 정리했다.
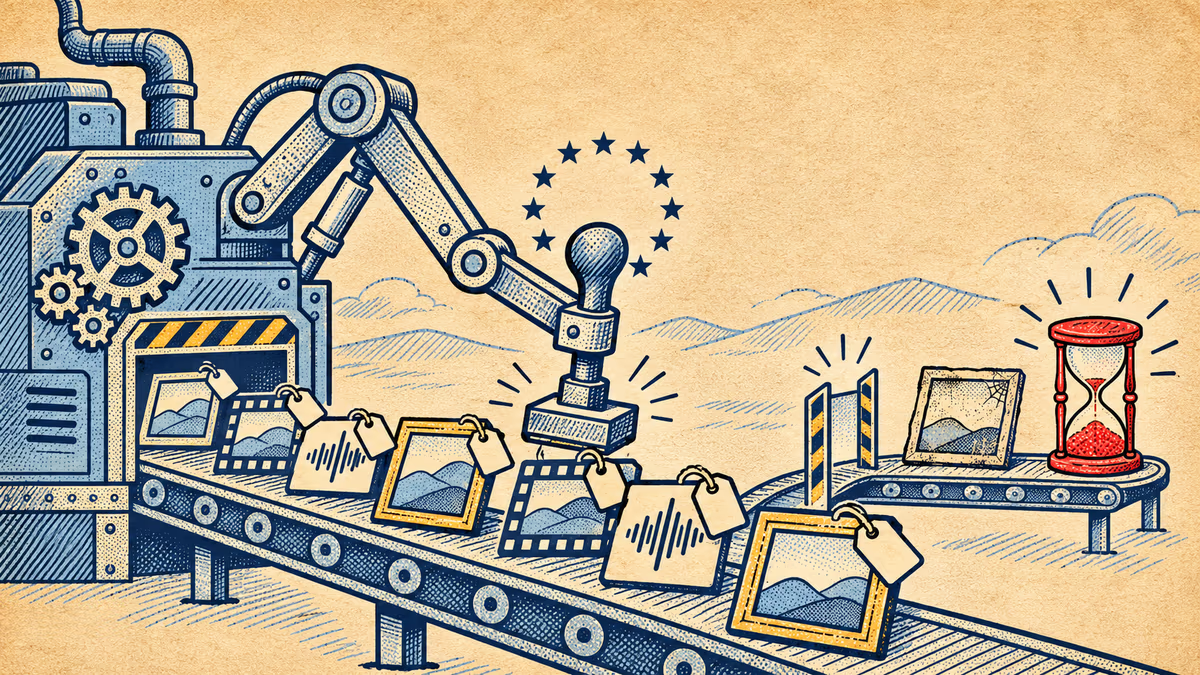
EU AI법 제50조의 딥페이크·AI 생성물 표시 의무는 8월 2일부터 적용 중이다. 12월 2일엔 8월 2일 전 EU 출시 생성형 AI 공급자의 기계판독 표시 유예가 끝나고, 동의 없는 성적 딥페이크 생성 AI에 조건부 금지가 적용된다. 한국 AI기본법도 표시 의무를 둔다.
AI기본법상 표시 위반 과태료는 시정명령을 따르지 않을 때 붙는다. PRISM이 대조한 한국 5개·대만 4개 현행 법률에서 AI 표시·공개 누락에 명령 없이 첫 위반부터 돈이 붙는 곳은 선거운동 딥페이크와 대만 플랫폼 광고 두 곳이다.
중국은 2025년 9월부터 AI 생성물 파일에 'AIGC' 메타데이터를 넣게 하고, 유통 플랫폼에 확인 의무를 뒀다. EU 실천강령 서명자는 이미지·영상·오디오에 메타데이터와 워터마크 두 겹을 자율로 약속한다. 갈리는 곳을 원문으로 본다.
HBM(고대역폭 메모리)은 D램을 수직으로 쌓아 AI 칩 옆에 붙인 메모리다. 적층·TSV 구조, HBM3·HBM4 표준 수치, SK하이닉스·삼성전자·마이크론 실적 자료에서 HBM 문구를 읽는 법을 정리했다.
EU AI법 제50조의 딥페이크·AI 생성물 표시 의무는 8월 2일부터 적용 중이다. 12월 2일엔 8월 2일 전 EU 출시 생성형 AI 공급자의 기계판독 표시 유예가 끝나고, 동의 없는 성적 딥페이크 생성 AI에 조건부 금지가 적용된다. 한국 AI기본법도 표시 의무를 둔다.
의견
이 기사에 대한 생각을 나눠주세요
로그인하고 의견을 남겨보세요