
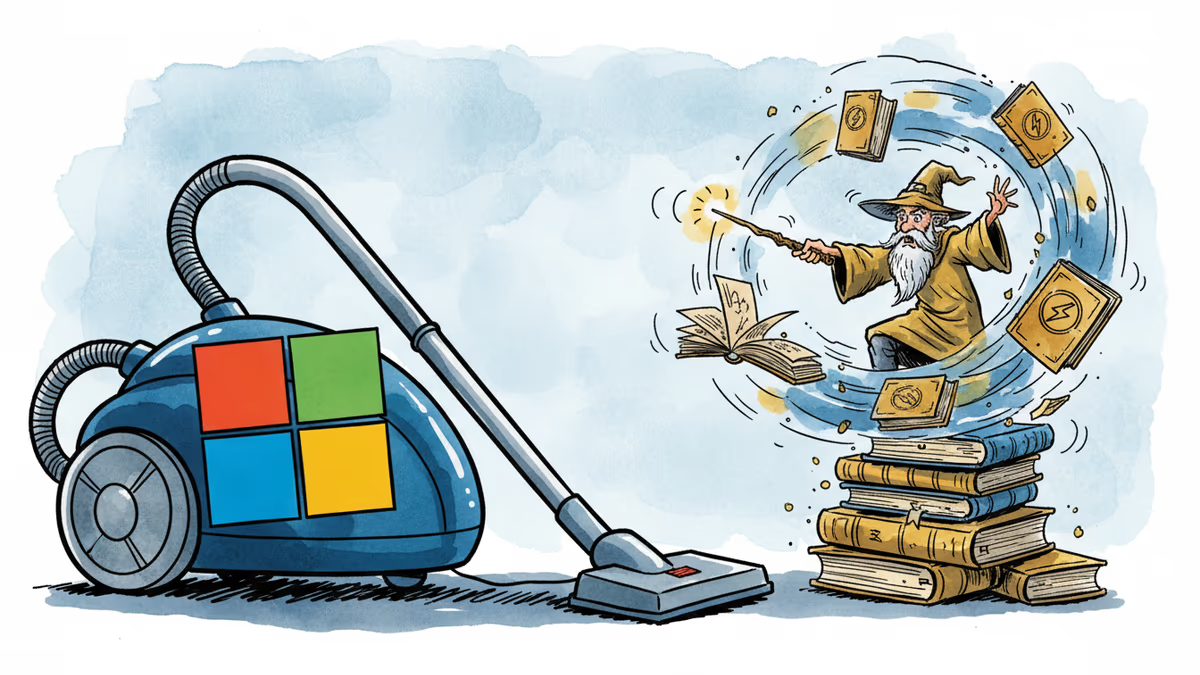
微軟刪除爭議博文:鼓勵開發者「盜版」哈利波特訓練AI?
微軟員工博文建議使用哈利波特書籍訓練AI模型引發爭議後被刪除,凸顯AI訓練數據版權問題的複雜性。
一篇看似技術教學的博文,為何會讓科技巨頭微軟緊急刪除?答案藏在幾行代碼背後的版權雷區中。
風暴的起源
2024年11月,微軟資深產品經理波賈·卡馬斯(Pooja Kamath)在公司博客發表文章,介紹如何使用Azure SQL DB、LangChain和大型語言模型,讓開發者能以「幾行代碼」為應用程式添加生成式AI功能。
問題出現在示範環節。為了展示「引人入勝且貼近生活的例子」,卡馬斯建議使用「知名數據集」——哈利波特系列書籍。這個建議在Hacker News引發軒然大波,批評者認為這等於鼓勵開發者盜版受版權保護的作品來訓練AI模型。
面對輿論壓力,微軟迅速刪除了這篇博文,但網路存檔已經保留了完整內容。

華人科技圈的反思
這起事件對華人科技生態系統具有特殊意義。在台灣,聯發科、台積電等科技公司正積極布局AI晶片和解決方案;在香港和新加坡,金融科技公司大量運用AI進行風險控制和客戶服務。
然而,相較於美國的「合理使用」原則,華人地區的版權法律環境更加嚴格。這意味著華人企業在AI開發中面臨更高的法律風險,同時也可能在全球競爭中處於相對保守的位置。
灰色地帶的擴張
有趣的是,卡馬斯在微軟工作超過十年,按理說應該對公司的法律政策相當熟悉。她的博文是個人疏忽,還是反映了整個科技行業對AI訓練數據版權問題的模糊認知?
從OpenAI到Google,各大科技公司都曾面臨類似爭議。許多AI模型的訓練數據來源不明,版權狀況存疑。這次微軟的快速刪文動作,或許正說明了業界對這個問題的敏感度正在提高。
相關文章

韓國AI基本法的標示違規,要在不遵守改正命令時才處以罰鍰。PRISM對照韓國5部、台灣4部現行法律,AI標示或揭露缺漏不經命令、首次違規就開罰的,是韓國競選活動深偽與台灣平台廣告兩處。

中國自2025年9月起,要求AI生成內容的檔案寫入「AIGC」詮釋資料,並要求傳播平台查核。歐盟行為準則的簽署者則自願承諾在圖片、影片、音訊加上詮釋資料與浮水印兩層標記,本文對照原文看兩者分歧。

HBM(高頻寬記憶體)是把DRAM垂直堆疊、緊貼在AI晶片旁的記憶體。本文說明其結構、HBM3與HBM4標準數字,並整理SK海力士、三星電子、美光財報中HBM文字的讀法。
歐盟AI法第50條的深偽與AI生成內容標示義務,8月2日起已適用。12月2日到期的只有8月2日前已上市生成式AI提供者的機器可讀標示緩衝,同日起另有未經同意性深偽生成AI的有條件禁令。
韓國AI基本法的標示違規,要在不遵守改正命令時才處以罰鍰。PRISM對照韓國5部、台灣4部現行法律,AI標示或揭露缺漏不經命令、首次違規就開罰的,是韓國競選活動深偽與台灣平台廣告兩處。
中國自2025年9月起,要求AI生成內容的檔案寫入「AIGC」詮釋資料,並要求傳播平台查核。歐盟行為準則的簽署者則自願承諾在圖片、影片、音訊加上詮釋資料與浮水印兩層標記,本文對照原文看兩者分歧。
HBM(高頻寬記憶體)是把DRAM垂直堆疊、緊貼在AI晶片旁的記憶體。本文說明其結構、HBM3與HBM4標準數字,並整理SK海力士、三星電子、美光財報中HBM文字的讀法。
歐盟AI法第50條的深偽與AI生成內容標示義務,8月2日起已適用。12月2日到期的只有8月2日前已上市生成式AI提供者的機器可讀標示緩衝,同日起另有未經同意性深偽生成AI的有條件禁令。
觀點
分享您對這篇文章的看法
登入加入討論