
AIが作った偽の引用文を掲載したメディア、信頼回復の道は?
技術メディアArs TechnicaがAI生成の偽引用文を掲載し謝罪。メディア業界のAI利用ルールと読者の信頼について考える。
技術に詳しいはずのメディアが、技術に騙された。
何が起きたのか
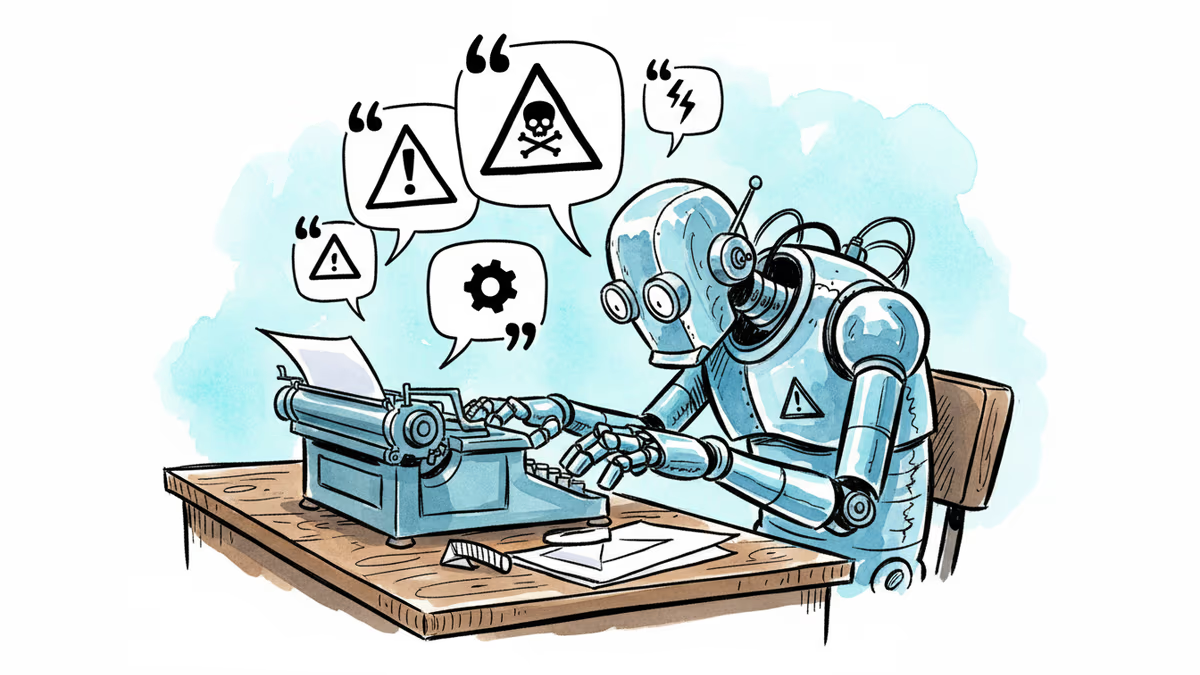
金曜日の午後、著名な技術メディアArs Technicaが衝撃的な謝罪文を発表しました。記事内で使用した直接引用が、実はAIによって生成された偽の発言だったというのです。取材源となった人物は、記事に書かれた言葉を一切発していませんでした。
Ars Technicaは数年間にわたってAIツールへの過度な依存リスクを報道してきた媒体です。皮肉にも、そのメディア自身がAIの落とし穴にはまってしまったのです。編集部は「深刻な基準違反」として事態を重く受け止め、社内ポリシーに反する行為だったと認めました。
現在のところ、これは単発の事件とみられていますが、最近の記事の見直しも行われています。
なぜ今、この問題が重要なのか
ChatGPTやClaudeといった生成AIが急速に普及する中、メディア業界は効率化と正確性の狭間で揺れています。記事作成の補助ツールとしてAIを活用する媒体は増えていますが、今回の事件は「便利さの代償」を浮き彫りにしました。

日本でも、NHKや朝日新聞などの大手メディアがAI活用のガイドラインを策定し始めています。しかし、現場レベルでの運用となると、線引きは曖昧になりがちです。「要約は良いが引用は駄目」「翻訳補助は可能だが創作は禁止」—こうしたルールを、忙しい記者やライターがどこまで守れるでしょうか。
読者の信頼をどう取り戻すか
Ars Technicaの対応は迅速でした。問題記事の修正、透明な謝罪、再発防止策の明示。しかし、一度失った信頼を取り戻すのは容易ではありません。
特に技術メディアにとって、この問題は深刻です。AIの可能性とリスクを解説する立場でありながら、自らがその罠にかかってしまった。読者からすれば「あなたたちが騙されるなら、私たちはどうすれば良いのか」という疑問が生まれるでしょう。
日本のメディア業界では、誤報や偏向報道に対する読者の目は厳しくなっています。SNSで瞬時に拡散される時代、一つのミスが媒体の存続を左右することもあります。
技術と人間の境界線
今回の事件は、より大きな問題を提起します。AIが人間の言葉を完璧に模倣できる時代に、「本物」と「偽物」をどう見分けるのか。そして、効率性を追求するあまり、ジャーナリズムの根幹である「事実確認」が軽視されていないか。
GoogleやMicrosoftはAIを検索エンジンに統合し、MetaはSNSでのAI生成コンテンツ表示を拡大しています。こうした流れの中で、メディアだけがAIを使わずにいることは現実的ではないでしょう。
問題は「使うか使わないか」ではなく、「どう使うか」です。
関連記事

韓国AI基本法の表示違反は、是正命令に従わないときに過料がかかります。PRISMが照合した韓国5本・台湾4本の現行法律で、AI表示・開示の漏れに命令を経ず初回の違反から金銭的な制裁がかかるのは、選挙運動ディープフェイクと台湾のプラットフォーム広告の2か所です。

中国は2025年9月から、AI生成物へのAIGCメタデータ付与と流通プラットフォームの確認を義務づけました。EUの行動規範は、署名者が画像・動画・音声にメタデータと電子透かしの二層を自主的に約束する仕組みです。

HBM(広帯域メモリ)は、DRAMを縦に積み重ねてAIチップのすぐ横に置くメモリです。仕組みとHBM3・HBM4の規格値、SKハイニックス・サムスン電子・マイクロンの決算資料でのHBMの読み方を整理しました。
EU AI法第50条のディープフェイク表示義務は8月2日から適用されています。12月2日に終わる猶予は、8月2日より前に市場投入した生成AI提供者の機械可読表示だけです。同日、同意のない性的ディープフェイク生成AIへの条件付き禁止も始まります。
韓国AI基本法の表示違反は、是正命令に従わないときに過料がかかります。PRISMが照合した韓国5本・台湾4本の現行法律で、AI表示・開示の漏れに命令を経ず初回の違反から金銭的な制裁がかかるのは、選挙運動ディープフェイクと台湾のプラットフォーム広告の2か所です。
中国は2025年9月から、AI生成物へのAIGCメタデータ付与と流通プラットフォームの確認を義務づけました。EUの行動規範は、署名者が画像・動画・音声にメタデータと電子透かしの二層を自主的に約束する仕組みです。
HBM(広帯域メモリ)は、DRAMを縦に積み重ねてAIチップのすぐ横に置くメモリです。仕組みとHBM3・HBM4の規格値、SKハイニックス・サムスン電子・マイクロンの決算資料でのHBMの読み方を整理しました。
EU AI法第50条のディープフェイク表示義務は8月2日から適用されています。12月2日に終わる猶予は、8月2日より前に市場投入した生成AI提供者の機械可読表示だけです。同日、同意のない性的ディープフェイク生成AIへの条件付き禁止も始まります。
意見
この記事についてあなたの考えを共有してください
ログインして会話に参加